Publications
(* indicates equal contribution)
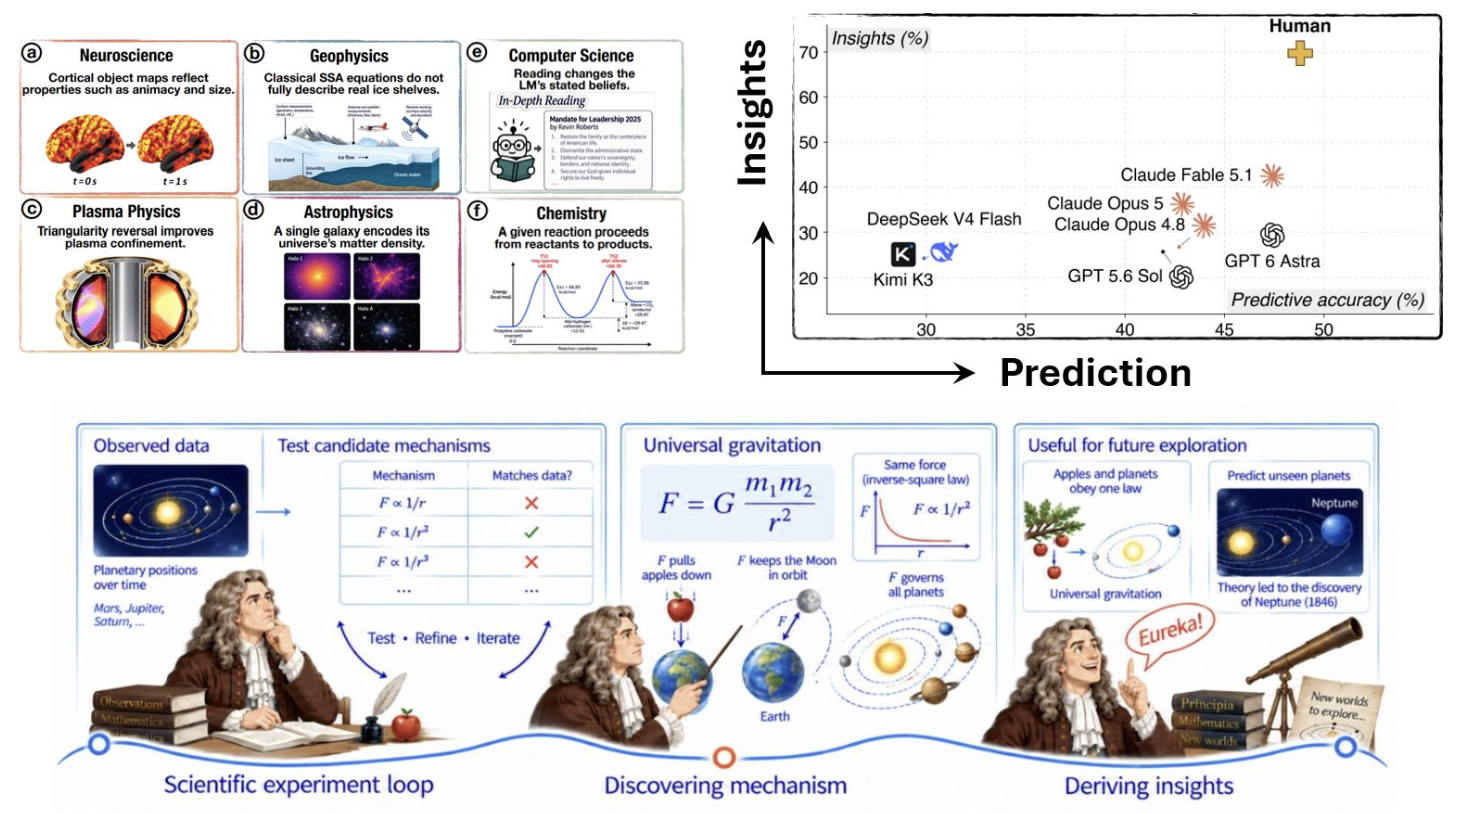
EurekaBench: Measuring Agentic Ability to Discover New Scientific Insights
Jiayi Geng, Zhengxuan Wu, Kevin S. Chen, Seungone Kim, Joseph Janssen, Zora Zhiruo Wang, Bhupalee Kalita, Runtian Gao, Aaron Ho, Andrew Oakleigh Nelson, Olexandr Isayev, Francisco Villaescusa-Navarro, Ching-Yao Lai, Howard Chen, Graham Neubig
Preprint
A benchmark of 26 expert-verified tasks across six scientific domains, evaluating AI agents' ability to discover mechanisms and derive scientific insights through long-horizon experiments.
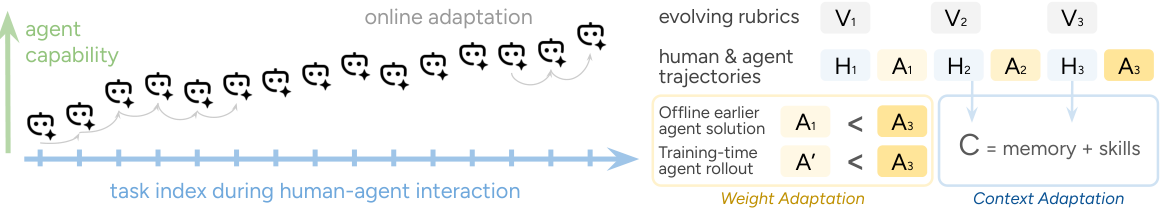
Efficient Test-Time Adaptation through Human-AI Interaction
Zora Zhiruo Wang, Apurva Gandhi, Rulin Shao, Aspen Chen, Jonas Mueller, Zhiqi Liang, Jett Chen, Michael Ryan, Qianou Ma, Luxi He, Zhoujun Cheng, Andre He, Seungone Kim, Jiayi Geng, Mingqian Zheng, Weiwei Sun, Zheyuan Zhang, Xinran Zhao, Yike Wang, Abe Hou, Liwei Jiang, Pang Wei Koh, Diyi Yang, Graham Neubig, Daniel Fried
Preprint
Adapting AI agents to individual users through human-agent interactions, with context and weight updates and evolving evaluation rubrics.
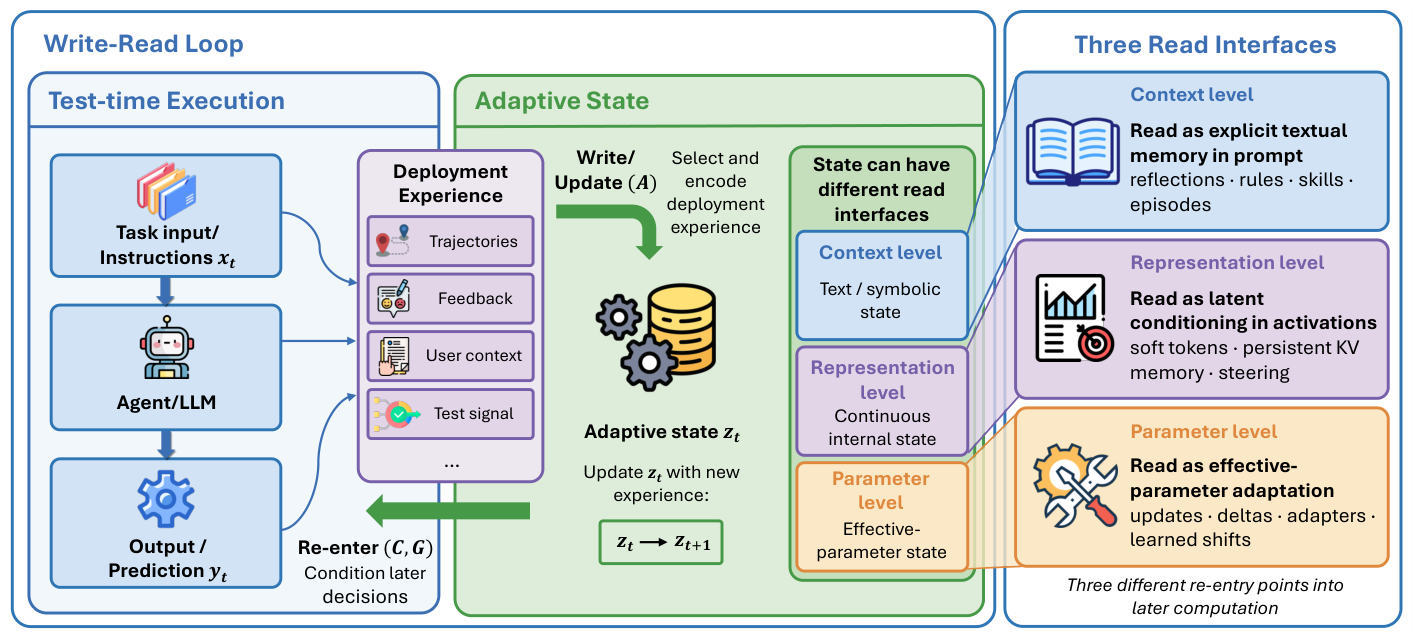
Learning from Use: Test-Time Learning in Large Language Models and Agents
Weihao Xuan, Qingcheng Zeng, Jiarui Liu, Rui Yang, Yunze Xiao, Yinxi Li, Zeqi Zhou, Weiwei Sun, Heli Qi, Leyang Cui, Tianhao Ma, Hanqun Cao, Junjue Wang, Tianyu Liu, Weihua Du, Yueqi Song, Jiayi Geng, Matthew Yu Heng Wong, Rob Voigt, Chuan Hong, Xiang Yue, Jen-tse Huang, Xuhai Xu, Yifan Peng, Pheng-Ann Heng, Yiming Yang, Bernhard Schölkopf, Zhijing Jin, Nan Liu, Naoto Yokoya, Mona Diab
Preprint
A review of test-time learning as a write-read loop that turns deployment experience into context-level, representation-level, or parameter-level adaptation.


PACE: A Proxy for Agentic Capability Evaluation
Yueqi Song, Lintang Sutawika, Jiarui Liu, Lindia Tjuatja, Jiayi Geng, Yunze Xiao, Daniel Lee, Aditya Bharat Soni, Vincent Lo, Xiang Yue, Graham Neubig
Preprint
A method that predicts expensive agentic benchmark performance from a compact subset of atomic evaluation instances.

Beyond Message Passing: A Semantic View of Agent Communication Protocols
Dun Yuan, Fuyuan Lyu, Ye Yuan, Weixu Zhang, Bowei He, Jiayi Geng, Linfeng Du, Zipeng Sun, Yankai Chen, Changjiang Han, Jikun Kang, Xi Chen, Haolun Wu, Xue Liu
Preprint
A three-layer semantic analysis of agent communication protocols, surveying 18 representative protocols and their support for meaning-level coordination.


Alita-G: Self-Evolving Generative Agent for Agent Generation
Jiahao Qiu, Xuan Qi, Hongru Wang, Xinzhe Juan, Yimin Wang, Zelin Zhao, Jiayi Geng, Jiacheng Guo, Peihang Li, Jingzhe Shi, Shilong Liu, Mengdi Wang
Preprint
A self-evolution framework that transforms a general-purpose agent into a domain expert by generating, abstracting, and curating MCP tools.


A Survey of Self-Evolving Agents: On Path to Artificial Super Intelligence
Huan-ang Gao†, Jiayi Geng†, Wenyue Hua†, Mengkang Hu†, Xinzhe Juan†, Hongzhang Liu†, Shilong Liu†, Jiahao Qiu†, Xuan Qi†, Qihan Ren†, Yiran Wu†, Hongru Wang†, Han Xiao†, Yuhang Zhou†, Shaokun Zhang†, Jiayi Zhang, Jinyu Xiang, Yixiong Fang, Qiwen Zhao, Dongrui Liu, Cheng Qian, Zhenhailong Wang, Minda Hu, Huazheng Wang, Qingyun Wu, Heng Ji, Mengdi Wang
TMLR 2026
A comprehensive survey of self-evolving agents and their path toward artificial super intelligence.

Are Large Language Models Reliable AI Scientists? Assessing Reverse-Engineering of Black-Box Systems
Jiayi Geng†, Howard Chen†, Dilip Arumugam, Thomas L Griffiths
COLM 2025 LM4Sci Workshop
Evaluating the reliability of LLMs as AI scientists through reverse-engineering assessments of black-box systems.

Mind Your Step (by Step): Chain-of-Thought Can Reduce Performance on Tasks Where Thinking Makes Humans Worse
Ryan Liu†, Jiayi Geng†, Addison J Wu, Ilia Sucholutsky, Tania Lombrozo, Thomas L Griffiths
ICML 2025
Demonstrating that chain-of-thought prompting can reduce LLM performance on tasks where deliberate thinking hurts human performance.

Levels of Analysis for Large Language Models
Alexander Ku, Declan Campbell, Xuechunzi Bai, Jiayi Geng, Ryan Liu, Raja Marjieh, R. Thomas McCoy, Andrew Nam, Ilia Sucholutsky, Veniamin Veselovsky, Liyi Zhang, Jian-Qiao Zhu, Thomas L Griffiths
Philos. Trans. R. Soc. A
Applying cognitive science tools to understand LLMs at multiple levels of analysis.


TreeBoN: Enhancing Inference-Time Alignment with Speculative Tree-Search and Best-of-N Sampling
Jiahao Qiu, Yifu Lu, Yifan Zeng, Jiacheng Guo, Jiayi Geng, Huazheng Wang, Kaixuan Huang, Yue Wu, Mengdi Wang
EMNLP Findings 2025
A method combining speculative tree-search with best-of-N sampling for better inference-time alignment.

Dr. GPT in Campus Counseling: Understanding Higher Education Students' Opinions on LLM-assisted Mental Health Services
Owen Xingjian Zhang, Shuyao Zhou, Jiayi Geng, Yuhan Liu, Sunny Xun Liu
Preprint
Understanding student opinions on LLM-assisted mental health services in campus counseling.

Language Models as Science Tutors
Alexis Chevalier, Jiayi Geng, Alexander Wettig, Howard Chen, Sebastian Mizera, Toni Annala, Max Jameson Aragon, Arturo Rodriguez Fanlo, Simon Frieder, Simon Machado, Akshara Prabhakar, Ellie Thieu, Jiachen T Wang, Zirui Wang, Xindi Wu, Mengzhou Xia, Wenhan Xia, Jiatong Yu, Jun-Jie Zhu, Zhiyong Jason Ren, Sanjeev Arora, Danqi Chen
ICML 2024
Exploring the effectiveness of language models as science tutors for educational applications.
